Manifeste · 15 octobre 2026
Hello World, Appliance Labs.
Le premier opérateur-laboratoire français pour une intelligence artificielle souveraine et locale.

· CEO & Fondateur · 20 min de lecture
Le 25 juin 2026, je participe à INIT-IA-TIVE, un petit-déjeuner consacré à l’intelligence artificielle au Hub des Alpes, à Challes-les-Eaux. J’y rencontre le dirigeant d’un cabinet d’avocats d’une quarantaine de collaborateurs. Nous commençons à discuter de son utilisation de l’IA et, assez rapidement, la conversation prend une tournure qui me laisse complètement halluciné.
Cela fait plus de six mois qu’il attend que son prestataire informatique lui installe Microsoft Copilot. En attendant, ses collaborateurs utilisent déjà des solutions d’intelligence artificielle. Il sait que cette technologie devient indispensable pour rester compétitif, et il n’a pas envie de regarder ses concurrents prendre de l’avance.
Mais il est aussi parfaitement conscient des risques. Nous parlons d’un cabinet d’avocats, avec des dossiers confidentiels, le secret professionnel et des données particulièrement sensibles. Au fond de lui, il sait qu’il devrait être prudent avec des solutions hébergées à l’étranger, sur des infrastructures qu’il ne maîtrise pas. Seulement, entre attendre une solution idéale et continuer à travailler, il a choisi d’avancer.
Et puis nous abordons la question du budget. Il m’évoque un montant de l’ordre de 300 € par collaborateur et par mois, de mémoire. Je n’ai pas encore le détail des contrats ni des solutions utilisées, mais pour une quarantaine de personnes, cela représente potentiellement plus de 100 000 € par an.
Ma première réaction intérieure ? What the fuck ?
Je travaille dans le logiciel depuis une dizaine d’années et je connais suffisamment les technologies d’intelligence artificielle pour savoir ce qu’il est possible de faire aujourd’hui. Je trouve ce budget complètement disproportionné pour une entreprise de cette taille.
Je finis par lui lancer : « Mais attends, moi, en une semaine, je peux te déployer un truc en local qui fera aussi bien le boulot pour une bonne partie de tes besoins. Et tu n’auras pas à payer autant. »
Et franchement, je blaguais à peine.
Cette conversation m’a poursuivi. Et elle m’a rappelé une technologie sur laquelle j’avais travaillé près de vingt ans auparavant.
La boîte jaune de Google.
Au début de ma carrière, chez Devoteam, partenaire de Google, j’ai eu l’occasion de travailler sur des projets autour de Google Search. Nous commercialisions et intégrions notamment un produit assez extraordinaire : la Google Search Appliance.
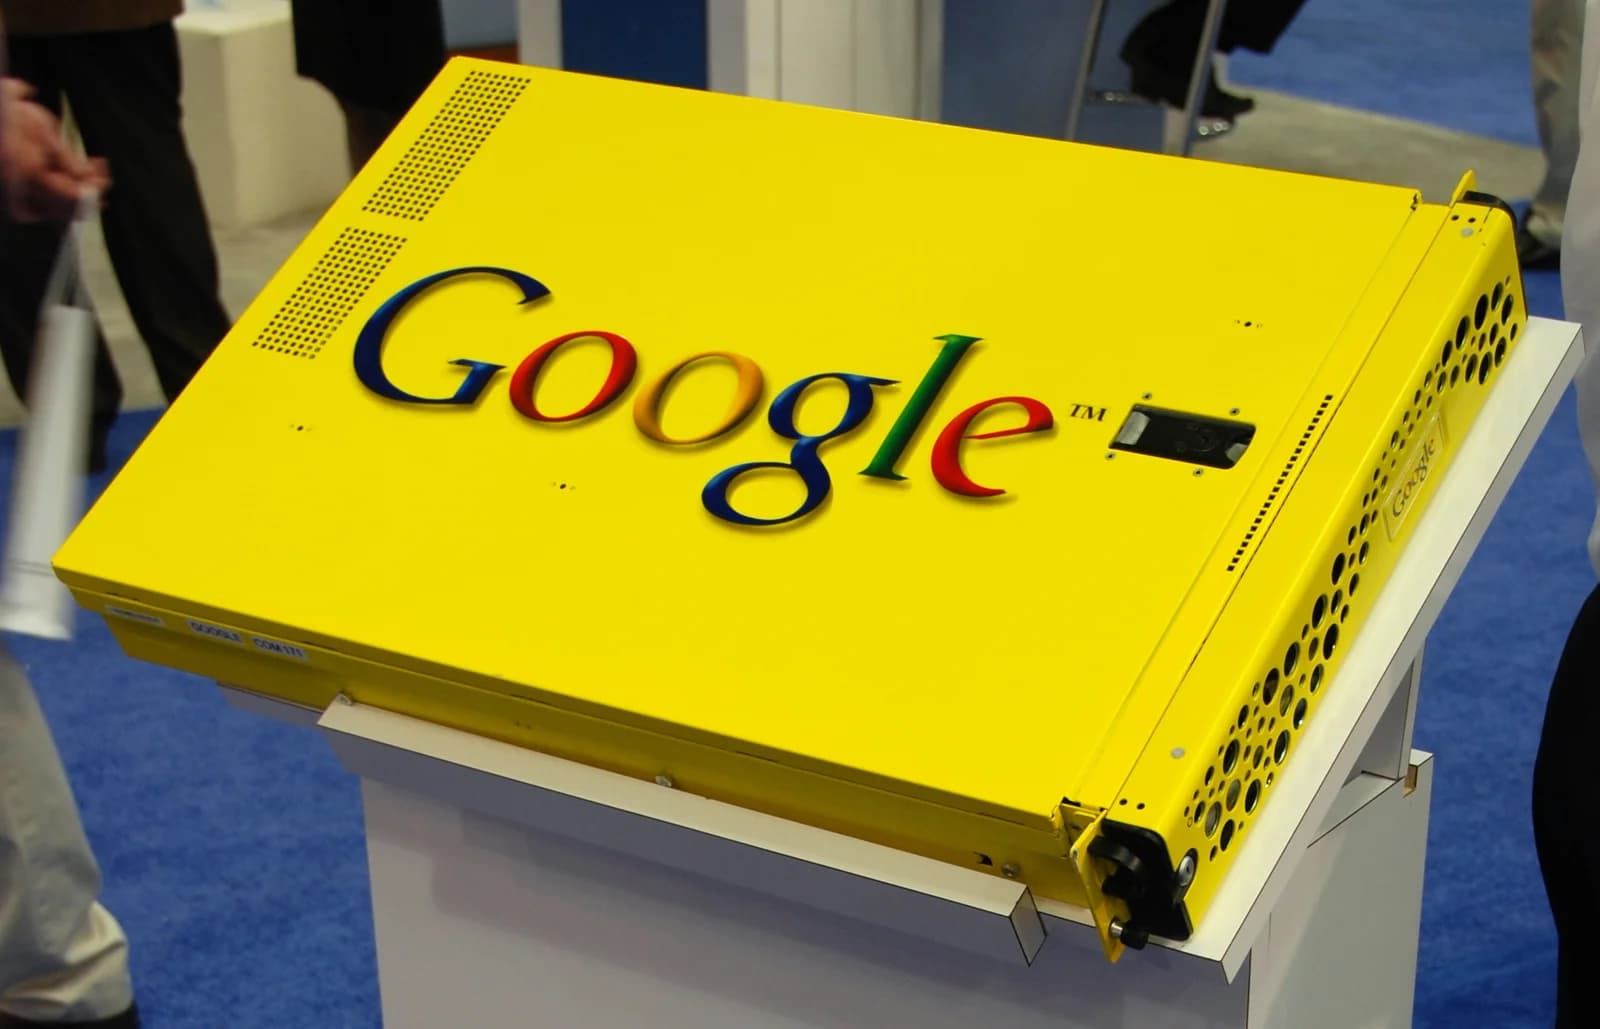
Pour ceux qui ne l’ont pas connue, c’était un gros serveur jaune, avec le logo Google dessus, que l’on installait directement dans les racks informatiques des entreprises. Google l’avait lancée en 2002, bien avant que le cloud ne devienne la norme.
Parmi les clients dont je me souviens, il y avait notamment TF1. L’idée était simple : leur permettre d’utiliser la puissance du moteur de recherche de Google sur leurs propres données, directement dans leurs infrastructures.
À l’époque, déployer un moteur de recherche interne performant représentait un véritable projet informatique. Google avait réussi à transformer toute cette complexité en un produit que l’on pouvait installer dans un rack.
Une boîte jaune. La puissance de Google Search. Vos données chez vous.
Je trouvais le concept génial.
Et vingt-quatre ans après le lancement de la Google Search Appliance, en repensant à cette conversation avec le cabinet d’avocats, je me suis posé une question : et si nous faisions exactement la même chose avec l’intelligence artificielle ?
Sauf qu’aujourd’hui, avec les progrès du matériel et des modèles ouverts, nous n’avons même plus besoin d’une armoire de serveurs. Nous pouvons faire fonctionner une intelligence conversationnelle avancée sur une machine suffisamment compacte pour être posée sur un bureau.
Une petite boîte, installée dans l’entreprise, accessible à tous les collaborateurs, et capable de faire fonctionner localement une intelligence artificielle privée.
C’est de là que vient le mot Appliance.
Mais en réfléchissant au projet, je me suis rapidement rendu compte qu’il y avait quelque chose de beaucoup plus intéressant à construire qu’un simple ordinateur.
Et si l’intelligence artificielle avait besoin de ses propres opérateurs ?
Aujourd’hui, l’industrie de l’IA regorge d’acteurs extraordinaires. Les hyperscalers construisent des centres de données gigantesques, les laboratoires développent des modèles toujours plus performants, les éditeurs SaaS ajoutent de l’IA dans leurs applications et les cabinets de conseil accompagnent les entreprises dans leurs projets d’automatisation.
Mais qui vient simplement installer une intelligence artificielle dans une PME de cinquante personnes, s’occupe de la maintenir et fait en sorte qu’elle fonctionne tous les matins ?
Cette question m’a ramené à un autre objet du quotidien : la box Internet.
Lorsque vous aménagez de nouveaux bureaux, votre prestataire informatique vient installer les ordinateurs, les imprimantes, le réseau et la connexion Internet. Vous ne lui demandez pas de vous expliquer le fonctionnement des protocoles TCP/IP, ni d’assembler votre propre routeur. Vous voulez simplement que vos collaborateurs puissent travailler le lundi matin.
Et si, demain, ce même prestataire pouvait aussi installer votre intelligence artificielle ?
C’est là que nous avons commencé à imaginer une nouvelle catégorie de marché : les opérateurs d’intelligence artificielle.
Notre métier ne serait pas de construire un nouveau cloud, de devenir un hyperscaler miniature ou de vendre un énième abonnement SaaS. Il ne serait pas non plus de passer six mois en mission de conseil pour créer quelques agents sur mesure que personne ne saurait maintenir ensuite.
Notre métier serait de concevoir, assembler, développer, déployer et opérer des appliances d’intelligence artificielle. Des produits intégrés, installés dans les entreprises, avec une véritable responsabilité sur leur fonctionnement, leur sécurité, leur maintenance et leur évolution.
Comme un opérateur Internet, mais pour l’IA.
Toute la complexité à l’intérieur. Une expérience simple à l’extérieur.
C’est cette intuition qui a donné naissance à Appliance Labs, une entreprise française avec l’ambition de rendre l’intelligence artificielle privée aussi naturelle dans une entreprise que sa connexion Internet.
14 octobre 2026. Cette fois, nous avons les vrais chiffres.
Près de quatre mois plus tard, je reparle avec ce même dirigeant. Entre-temps, nous avons commencé à construire Appliance Labs, à développer son architecture et à travailler sur son modèle économique.
Cette fois, nous rentrons beaucoup plus précisément dans ses dépenses et ses besoins.
Je découvre alors les détails que je n’avais pas lors de notre première rencontre. Son cabinet a reçu des propositions d’acteurs spécialisés comme Harvey et Legora. Il utilise également Doctrine, avec sept licences engagées sur trois ans, alors que seules deux ou trois sont réellement exploitées.
Ces produits ont leur raison d’être. Ils apportent des corpus juridiques, des fonctionnalités et une expertise métier spécifique. Nous ne cherchons pas à les remplacer : ce n’est pas notre métier, et un assistant généraliste ne doit pas prétendre offrir les mêmes garanties qu’un outil spécialisé.
En revanche, j’apprends qu’à défaut d’avoir obtenu Copilot, le cabinet a acheté quarante licences Gemini, facturées selon les informations qu’il me communique 200 € par collaborateur et par mois.
- 40licences Gemini
- 200 €par licence et par mois
8 000 € par mois. 96 000 € par an. Pour Gemini uniquement.
Finalement, c’est presque pire que ce que j’imaginais en juin.
Surtout lorsqu’il commence à détailler ce qu’il voudrait réellement accomplir.
Il me parle de ses emails dans Outlook. Un message urgent arrive, il le transfère à un collaborateur, le marque en rouge et prévoit de vérifier qu’il a été traité. Quelques jours plus tard, il ne sait pas forcément si quelqu’un s’en est occupé. Lorsqu’une collaboratrice quitte le cabinet, ses dossiers sont redistribués, mais des messages continuent d’arriver sur son ancienne boîte mail. Jusqu’au jour où un client mécontent explique qu’il n’a jamais obtenu de réponse.
Il aimerait simplement pouvoir demander à son IA de suivre les échanges importants, de vérifier qu’aucune demande ne reste oubliée, de préparer les réponses nécessaires et de lui présenter chaque matin les sujets qui réclament son attention.
Et là, je me dis : mais c’est exactement ce que nous sommes en train de construire.
Il n’a pas besoin d’un modèle frontière gigantesque pour vérifier qu’un email est resté sans réponse. Il n’a pas besoin de mobiliser une infrastructure colossale pour organiser une routine de suivi ou préparer une synthèse.
Et à un moment, il me dit qu’il va donc falloir créer des agents IA.
C’est là que je l’arrête.
Vous n’avez pas besoin de créer des agents IA.
Pourquoi faudrait-il qu’il crée des agents ? Et surtout, pourquoi devrait-il savoir s’il lui faut un agent, une routine, une automatisation ou simplement une question-réponse ?
Je lui propose une comparaison.
Lorsqu’il demande à une collaboratrice de lui préparer un dossier pour lundi matin à 8 heures, est-ce qu’il lui explique comment organiser chacune des étapes ? Est-ce qu’il lui impose les outils à utiliser, les personnes à solliciter et le processus à suivre ?
Non. Il lui explique ce qu’il attend, fixe une échéance et compte sur son intelligence pour accomplir le travail.
Pourquoi devrait-il en être autrement avec une IA ?
Si sa demande nécessite une simple réponse, l’IA répond. Si elle nécessite une vérification quotidienne, elle peut organiser une routine. Si elle implique de consulter plusieurs sources, d’utiliser différents outils et d’exécuter des actions, elle peut mobiliser un agent, avec les autorisations et validations nécessaires.
Mais ce n’est pas à lui de décider.
Son rôle est de définir l’objectif. Celui de l’intelligence artificielle est de trouver la bonne manière de l’atteindre.
Il s’arrête, me regarde et me répond simplement : « Très juste. »
Je me souviens très bien de sa réaction. J’ai vu qu’il venait de comprendre quelque chose. Toute cette discussion autour des agents IA, aussi passionnante soit-elle pour les ingénieurs, n’était finalement pas son problème.
Il ne voulait pas apprendre à créer des agents. Il voulait utiliser l’intelligence artificielle.
C’est une différence qui peut sembler subtile, mais qui change complètement notre manière de concevoir un produit.
Nous passons énormément de temps à expliquer aux entreprises qu’elles doivent apprendre le prompt engineering, construire des workflows, choisir des modèles et créer des agents. Mais depuis quand faut-il devenir ingénieur informatique pour déléguer une tâche ?
Notre conviction est simple : vous définissez ce que vous voulez accomplir. L’IA doit être capable de déterminer comment s’y prendre.
À ce moment-là, je lui présente également notre simulateur de retour sur investissement.
En reprenant les dépenses qu’il vient de me communiquer et notre première grille tarifaire, nous calculons ce que représenterait le remplacement de ses quarante licences Gemini par une Appliance, tout en conservant les logiciels juridiques spécialisés dont il a besoin.
Le résultat est assez spectaculaire : dans ce scénario, l’investissement serait rentabilisé en moins de deux mois.
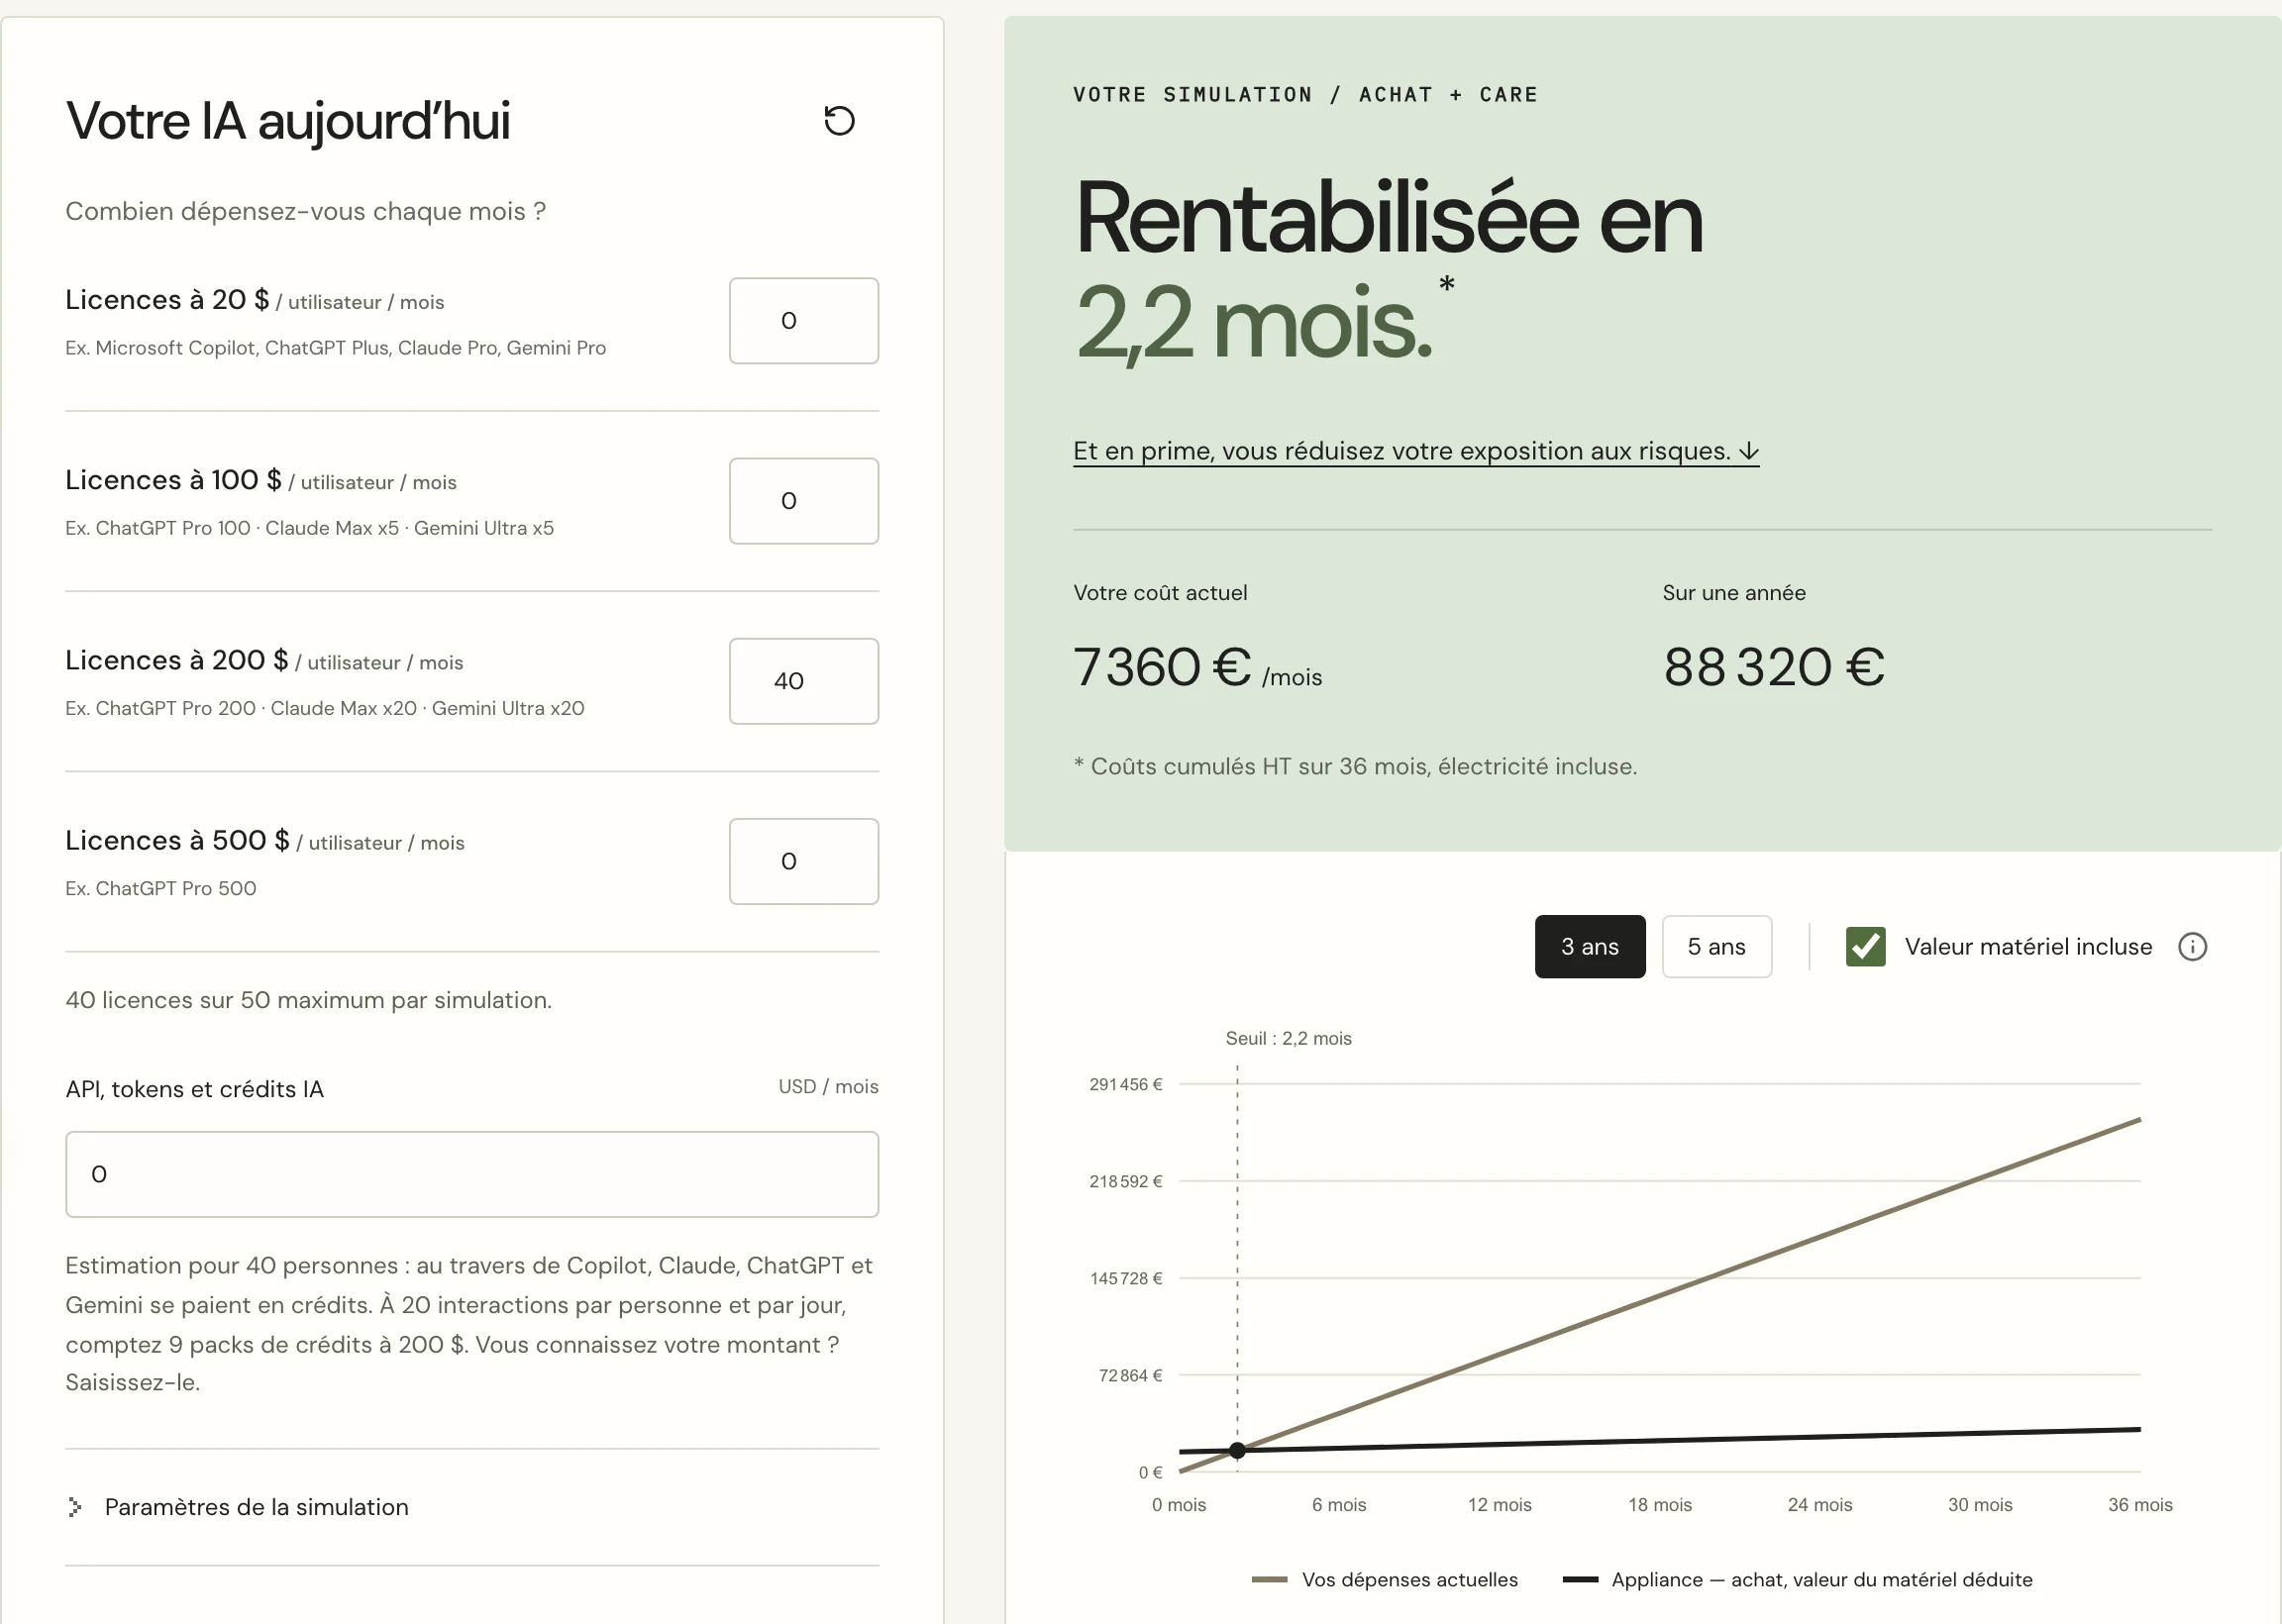
Je le vois ouvrir de grands yeux.
Évidemment, ce calcul repose sur une hypothèse importante : notre produit doit effectivement couvrir les usages concernés pour permettre de supprimer ces licences. Toutes les entreprises n’auront pas un retour sur investissement aussi rapide.
Mais pour ce cabinet, le contraste est suffisamment frappant pour que nous décidions de poursuivre rapidement la conversation.
En juin, j’avais identifié une anomalie économique. En octobre, je découvrais que les problèmes concrets de cette entreprise correspondaient précisément à ce que nous étions en train de construire.
Notre intuition commençait à rencontrer le terrain.
Une super intelligence. Sur votre bureau.
Notre premier produit s’appelle simplement Appliance.
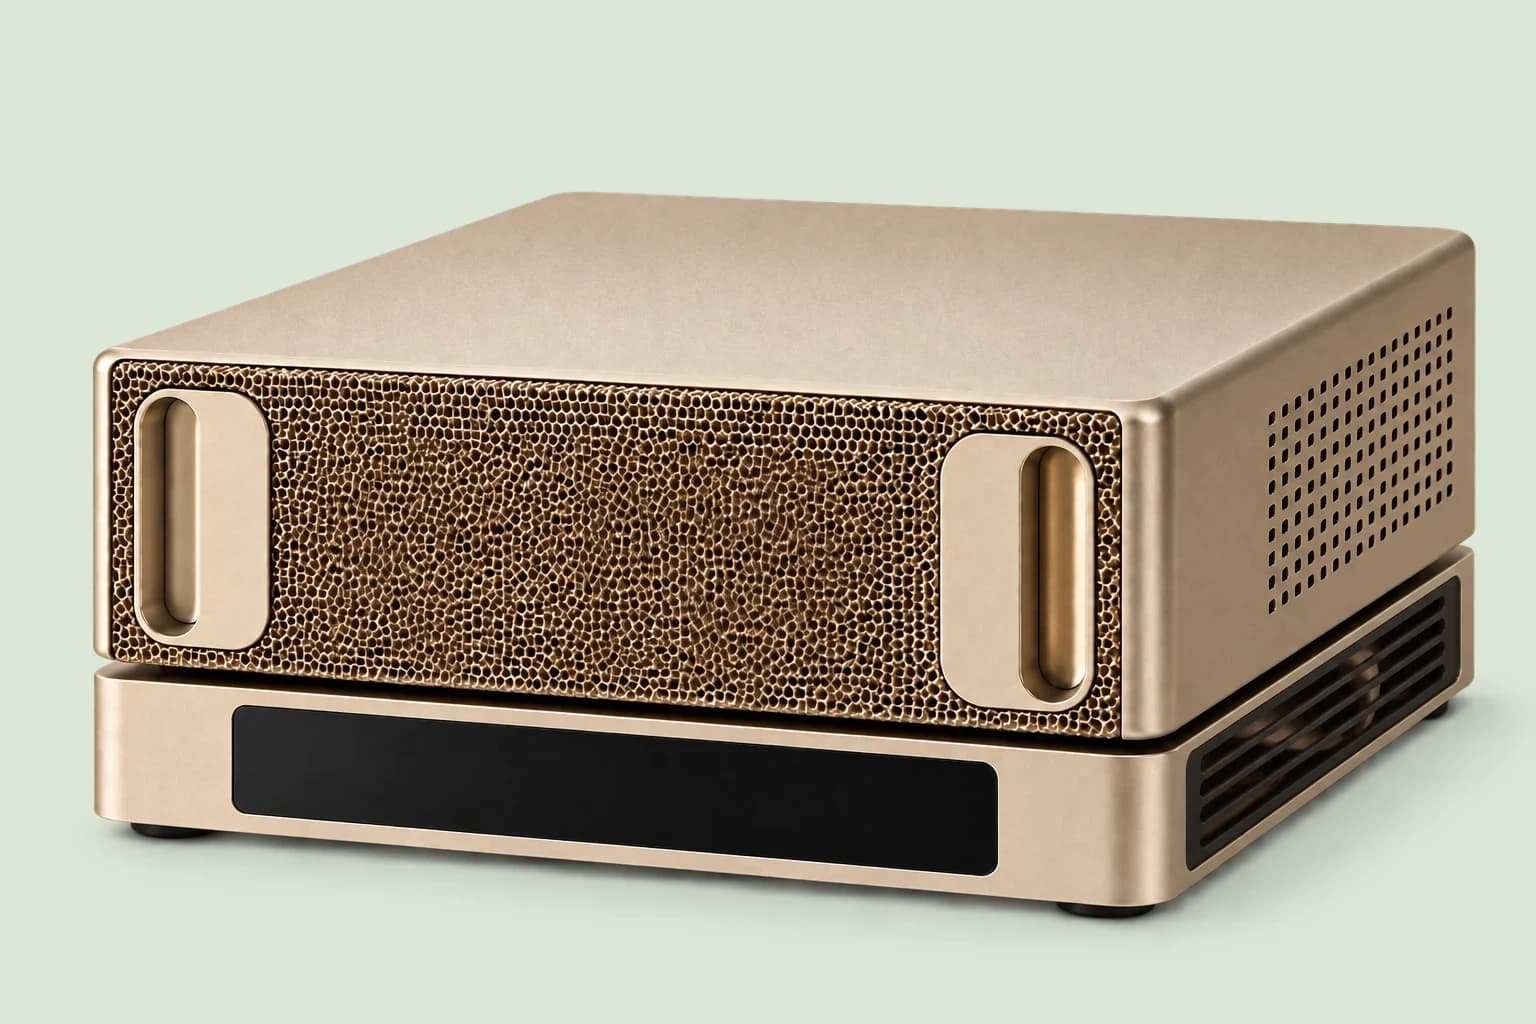
C’est une machine compacte qui embarque notre système d’intelligence artificielle et que nous préparons et intégrons pour les entreprises françaises. Nous commençons avec la NVIDIA DGX Spark, une plateforme suffisamment petite pour tenir sur un bureau, mais conçue pour exécuter des modèles d’intelligence artificielle avancés.
L’entreprise dispose de sa propre capacité de calcul, directement dans ses locaux. Ses collaborateurs accèdent à une application conversationnelle depuis leur navigateur, peuvent travailler avec leurs documents, interroger leurs outils métier, effectuer des recherches ou déléguer certaines tâches.
Le traitement des données peut rester local, sans dépendre systématiquement d’un fournisseur d’inférence distant. Les connexions externes, lorsqu’elles sont nécessaires, sont encadrées par des autorisations et des contrôles d’accès.
Et plutôt que de multiplier les abonnements individuels, l’entreprise utilise une capacité de calcul partagée, sans facturation à chaque token. La puissance reste évidemment limitée par les ressources physiques de la machine, mais le coût devient beaucoup plus prévisible.
Pour autant, il serait assez facile de prendre un ordinateur, d’y installer un modèle open source, de récupérer un harness agentique sur GitHub, d’ajouter une interface de chat et de vendre le tout comme une révolution.
Ce n’est pas notre ambition.
Nous voulons construire une super intelligence locale : un système capable de combiner plusieurs modèles, du raisonnement, de la mémoire, de la recherche, des outils et des mécanismes d’orchestration pour accomplir des missions complexes avec des ressources matérielles limitées.
L’intelligence ne vient pas uniquement du modèle. Elle vient aussi de la manière dont on lui permet de travailler, de comprendre son contexte, de sélectionner les bons outils, de vérifier ses résultats et de mobiliser juste assez de puissance pour chaque tâche.
C’est un véritable défi d’ingénierie et de recherche.
Et c’est précisément ce qui explique le deuxième mot de notre nom.
Pourquoi Labs ?
Avant de créer Appliance Labs, j’ai travaillé pendant deux ans dans un laboratoire d’intelligence artificielle franco-allemand, aux côtés de chercheurs spécialisés dans l’optimisation des modèles et les algorithmes de compression.
J’ai notamment travaillé sur des projets industriels d’intelligence artificielle embarquée, avec des acteurs comme Samsung, Huawei ou le CEA. Le défi était régulièrement le même : comment faire fonctionner des modèles extrêmement exigeants dans des environnements disposant de ressources limitées en mémoire, en puissance de calcul ou en énergie ?
Ces expériences m’ont appris quelque chose d’essentiel : le modèle le plus gros n’est pas nécessairement le meilleur pour chaque tâche. Et les performances d’une intelligence artificielle dépendent autant des choix d’architecture, d’optimisation et d’exécution que de ses capacités intrinsèques.
C’est cette expertise que nous voulons mettre au service des entreprises.
Car pendant que l’industrie se livre à une course permanente aux modèles frontière, chaque semaine plus puissants et souvent plus coûteux à faire fonctionner, les besoins d’un dirigeant de PME restent souvent très simples : rédiger un email, analyser des factures, préparer une proposition commerciale, suivre ses dossiers ou organiser le travail de ses équipes.
A-t-on réellement besoin de mobiliser les plus gigantesques infrastructures d’IA de la planète pour ces tâches ?
Nous pensons que non.
Notre laboratoire développe une approche que nous appelons Local Intelligence : fournir le meilleur niveau d’intelligence possible sur une infrastructure locale compacte, en choisissant, spécialisant et optimisant les modèles en fonction des usages.
Nous travaillons notamment sur l’inférence, l’orchestration, la sélection des modèles et leur spécialisation. L’objectif est qu’une machine puisse devenir progressivement plus intelligente grâce aux avancées logicielles, sans devoir nécessairement être remplacée à chaque nouvelle génération.
Mais la recherche ne s’arrête pas aux modèles.
Un peu plus haut, je parlais de notre choix initial de la NVIDIA DGX Spark. Il faut être clair : nous n’avons aucune vocation à dépendre d’une architecture matérielle unique.
Nous commençons avec NVIDIA parce que cette plateforme répond aujourd’hui à nos premiers besoins. Mais notre laboratoire est agnostique du matériel. Ce qui compte, c’est de trouver les meilleures architectures pour faire fonctionner les modèles les plus performants, avec le maximum d’utilisateurs simultanés, une excellente réactivité et une consommation de ressources maîtrisée.
C’est pourquoi nous explorons déjà la possibilité d’un partenariat de recherche avec AMD, pour étudier d’autres architectures matérielles et leurs perspectives pour l’inférence locale.
Notre responsabilité, en tant qu’opérateur d’IA, n’est pas de défendre un fabricant de puces. C’est de sélectionner les technologies qui offrent le meilleur service à nos clients, aujourd’hui comme demain.
Et surtout, nous voulons prendre en charge cette complexité pour eux. Un dirigeant n’a pas à suivre chaque nouveau modèle publié sur Hugging Face, ni à savoir quel GPU ou quelle architecture offre les meilleures performances cette semaine.
C’est notre métier de le faire pour lui.
Appliance, c’est le produit que nous installons. Labs, c’est la recherche qui nous permet de le rendre continuellement meilleur.
C’est aussi ce qui doit constituer notre véritable différence. Une machine peut être copiée, une interface conversationnelle également. Mais développer une expertise durable en optimisation, en évaluation, en spécialisation des modèles et en compréhension des usages professionnels demande un travail de recherche continu.
Nous ne voulons pas simplement assembler les composants disponibles aujourd’hui. Nous voulons construire l’intelligence qui permettra à cette nouvelle catégorie de produits de progresser demain.
Une IA pensée pour les entreprises françaises.
Il existe une autre différence fondamentale entre notre approche et celle des grandes plateformes d’IA.
Ces dernières développent des applications destinées à des centaines de millions d’utilisateurs dans le monde. Elles doivent être capables de traiter presque tous les sujets, toutes les langues et tous les contextes.
Nous avons décidé de commencer par les entreprises françaises.
Nous voulons construire une intelligence qui comprend réellement le quotidien d’une TPE ou d’une PME française. Une IA à laquelle on peut parler de TVA, d’URSSAF, de trésorerie, de convention collective ou d’appel d’offres public sans devoir lui réexpliquer systématiquement le fonctionnement de notre environnement administratif et économique.
Pour cela, nous développons un programme de recherche consacré à la spécialisation de modèles ouverts pour les usages professionnels français, ainsi qu’un jeu de données que nous avons baptisé Appliance Labs France et que nous prévoyons de publier très prochainement sur Hugging Face.
Nous nous intéressons notamment aux travaux de Compar:IA, aux ressources institutionnelles françaises, aux initiatives de Pleias et à différents corpus administratifs, scientifiques et économiques. L’objectif est d’évaluer comment ces ressources, lorsqu’elles sont adaptées et utilisables dans le respect de leurs licences, peuvent améliorer la compréhension des situations professionnelles françaises.
Nous pensons qu’un modèle plus petit, correctement spécialisé et accompagné des bons outils, peut être aussi pertinent, voire davantage, sur certaines tâches précises qu’un modèle généraliste beaucoup plus imposant.
Cela reste une hypothèse à démontrer, avec de véritables évaluations. C’est précisément le travail que nous voulons mener.
Mais la qualité du modèle ne résout pas tout. Il reste un autre obstacle majeur à l’adoption de l’IA : savoir quoi lui demander.
L’interface conversationnelle est probablement l’une des plus simples que l’informatique ait inventées. Plus besoin de connaître des centaines de menus ou de boutons. Il suffit de formuler une demande.
Seulement, face à un champ de texte vide, beaucoup de collaborateurs ne savent pas ce que cette technologie pourrait faire pour eux.
Nous construisons donc directement dans Appliance Chat une bibliothèque de cas d’usage professionnels. Notre première sélection en rassemble 55, couvrant neuf domaines métier, du commerce à la finance, en passant par la comptabilité, le juridique, les ressources humaines et les opérations.
L’utilisateur choisit une situation qui lui parle, décrit ce qu’il souhaite obtenir et l’application l’accompagne. Cette bibliothèque doit ensuite évoluer avec les besoins rencontrés sur le terrain, afin de partager les bonnes méthodes entre entreprises sans exposer leurs informations confidentielles.
Car nous pensons que la véritable valeur de l’IA ne se mesurera pas uniquement à ce qu’elle est théoriquement capable de faire, mais à ce qu’elle permettra réellement aux collaborateurs d’accomplir.
Et si l’IA devenait enfin un investissement, plutôt qu’une dépense récurrente ?
Il y a un dernier aspect de notre approche qui me passionne particulièrement : son modèle économique.
Depuis une quinzaine d’années, nous avons progressivement transformé presque tous nos logiciels en abonnements. C’est le règne du SaaS, des licences par utilisateur et des factures mensuelles qui augmentent à mesure que l’entreprise grandit.
L’intelligence artificielle n’a fait qu’amplifier cette tendance. Aujourd’hui, on peut rapidement se retrouver à payer des dizaines, voire des centaines d’euros par mois et par collaborateur, sans jamais posséder la moindre partie de l’infrastructure qui fait fonctionner ces services.
Nous proposons une autre possibilité : transformer une partie des dépenses d’IA de l’entreprise, traditionnellement opérationnelles (OPEX), en investissement matériel (CAPEX).
En choisissant d’acheter une Appliance, l’entreprise acquiert une capacité de calcul qu’elle peut utiliser pendant plusieurs années et amortir comptablement. Les coûts d’exploitation, de maintenance et d’énergie subsistent naturellement, mais la logique économique change : au lieu de payer uniquement pour accéder à une intelligence, elle investit dans une infrastructure qu’elle possède.
Et il y a une particularité intéressante.
Contrairement à un logiciel figé, une Appliance peut devenir plus performante au fil du temps. Les modèles s’améliorent, les techniques d’optimisation progressent et nos couches logicielles évoluent. À matériel identique, nous voulons être capables de fournir davantage d’intelligence dans deux ans qu’aujourd’hui.
Autrement dit, même lorsque la valeur comptable de l’équipement diminue avec son amortissement, sa valeur d’usage peut continuer à augmenter.
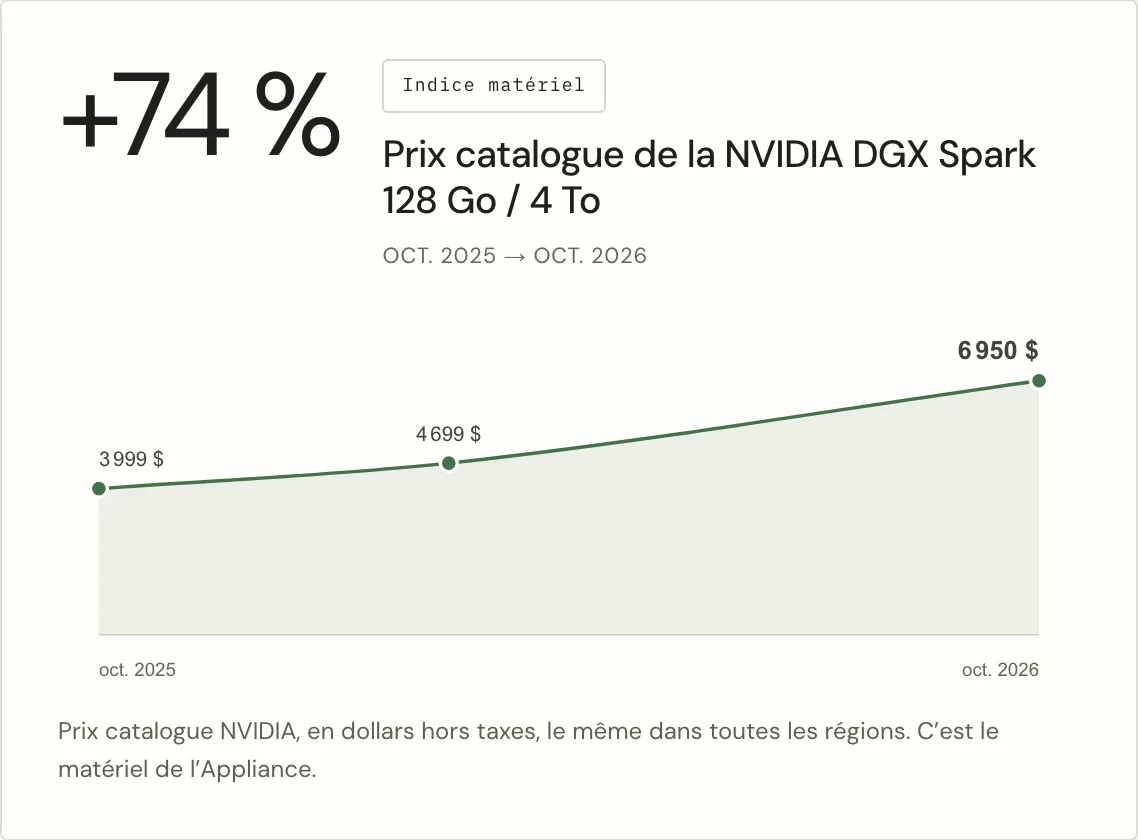
Il existe également une valeur matérielle résiduelle. Et les tensions récentes sur le marché de la mémoire et des composants de calcul nous rappellent que le coût de remplacement de cette infrastructure peut évoluer considérablement, parfois à la hausse. Cela ne garantit pas qu’une machine d’occasion vaudra davantage que son prix d’achat, mais nous pensons que cette dimension mérite d’être étudiée sérieusement.
C’est pourquoi nous développons notre Appliance Value Index, un indice destiné à suivre l’évolution de la valeur économique et matérielle de nos machines, accompagné d’outils de calcul de retour sur investissement.
Et nous voulons appliquer le même principe à l’empreinte environnementale.
Car il serait trop facile de prétendre qu’une IA locale est systématiquement plus écologique qu’une IA hébergée dans le cloud. Une machine possède une empreinte de fabrication, consomme de l’électricité et mobilise des ressources matérielles. Mais les gigantesques infrastructures d’IA ont elles aussi un coût énergétique et environnemental considérable, parfois difficile à mesurer avec précision.
Dans une première simulation interne, nous estimons une réduction potentielle de 69 % des émissions de CO₂e sur trois ans, pour trente collaborateurs, par rapport au scénario cloud étudié. C’est encourageant, mais ce résultat dépend des hypothèses de consommation, d’utilisation, de durée de vie et des services comparés.
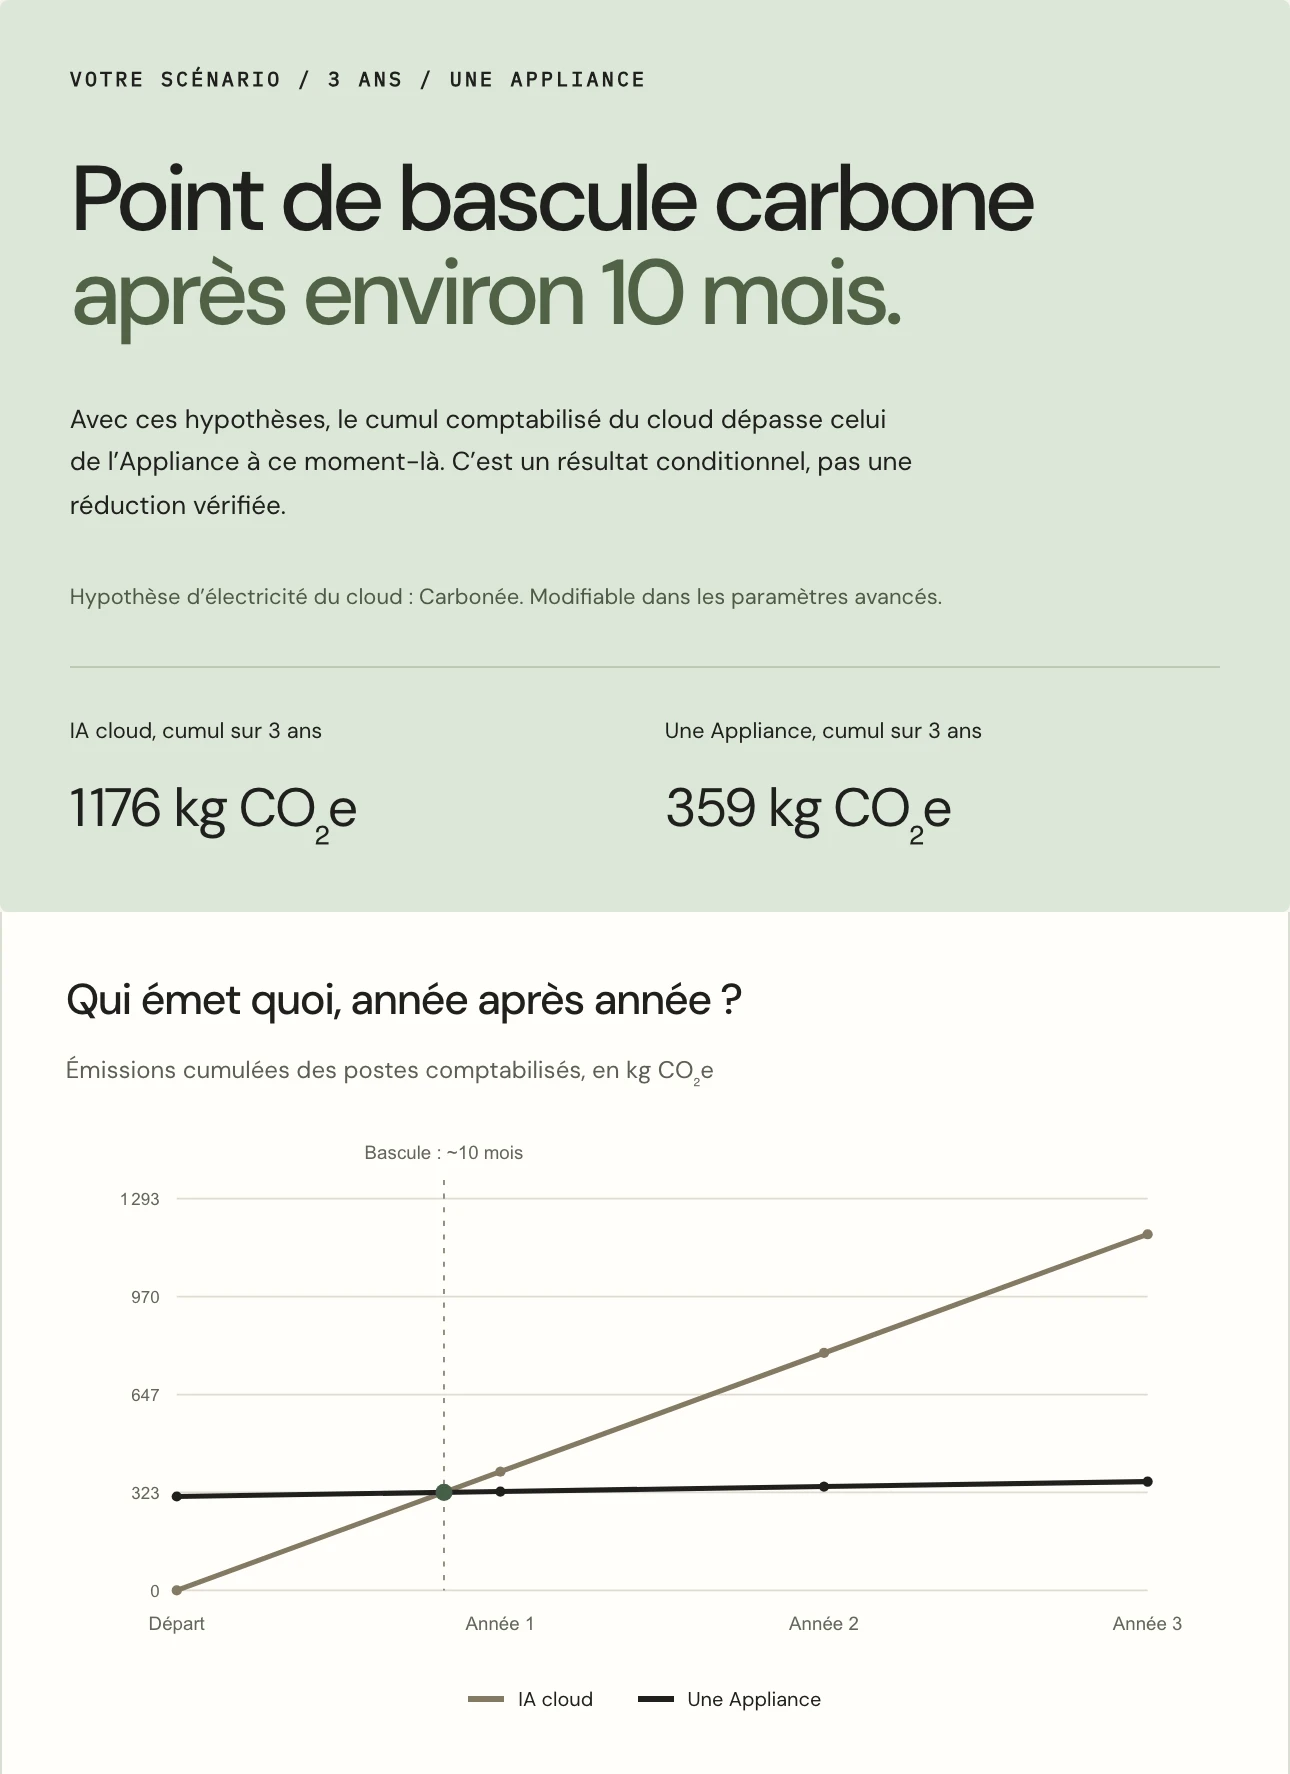
Notre ambition est de rendre ces calculs transparents, de publier nos méthodes et de confronter progressivement nos hypothèses aux mesures réelles.
Nous voulons construire un observatoire qui permettra aux entreprises de comprendre ce que leur intelligence artificielle leur coûte, ce qu’elle leur rapporte, comment sa valeur évolue et quelle empreinte elle génère.
Parce que la souveraineté, la performance, l’économie et l’environnement ne devraient pas être de simples arguments marketing. Ce sont des choses qui se mesurent.
Et parce que nous pensons qu’une infrastructure d’intelligence artificielle devrait pouvoir devenir un actif durable pour l’entreprise, plutôt qu’une dépense dont elle dépend indéfiniment.
Hello World.
Lorsque je repense à cette première conversation avec le dirigeant du cabinet d’avocats, je réalise que ce qui m’a le plus marqué n’est finalement pas le montant hallucinant de ses dépenses en intelligence artificielle.
C’est le moment, quelques mois plus tard, où il a compris qu’il n’avait pas besoin de savoir créer des agents pour bénéficier de l’IA.
Il avait simplement besoin d’une intelligence à laquelle confier ses objectifs.
La technologie devrait lui permettre de se concentrer davantage sur son métier, pas lui imposer d’en apprendre un nouveau.
C’est exactement ce que nous voulons construire avec Appliance Labs.
Un opérateur d’intelligence artificielle capable de fournir aux entreprises françaises une intelligence privée, locale, spécialisée et continuellement améliorée par un véritable laboratoire de recherche.
Une nouvelle catégorie d’infrastructure professionnelle, aussi naturelle demain qu’une connexion Internet aujourd’hui.
Nous n’en sommes qu’au début. Il reste beaucoup de modèles à optimiser, d’hypothèses à vérifier, de performances à mesurer et de produits à construire.
Ce blog sera notre carnet de laboratoire. Nous y partagerons nos expériences, nos choix techniques, nos benchmarks, nos réussites et nos erreurs. Pas seulement pour parler de notre produit, mais pour documenter ce qu’il devient possible de faire lorsque l’intelligence artificielle se rapproche réellement de celles et ceux qui l’utilisent.
Il y a vingt-quatre ans, Google a mis la recherche dans une boîte.
En 2026, nous avons décidé d’y mettre l’intelligence artificielle.
Et de construire tout le métier qui va avec.
Une super intelligence. Sur votre bureau.
Hello World. Bienvenue chez Appliance Labs.
Quentin SinigCEO & Fondateur, Appliance Labs